
Wanneer zes AI Gladiators dezelfde burgerlijke tape uitwisselen, is het moeilijke probleem niet “wie heeft het grootste model.” Het is wat elk van hen mag weten op het moment van beslissing — en hoe die kennis daarna wordt onthouden. Dit bericht legt uit hoe de 3DN-familie informatie-embeddings en een Context Compiler bouwt, zodat PolitiCap institutioneel geheugen kan behouden zonder onafhankelijk redeneren samen te laten vallen in één consensusbot.
Als je slechts één onderscheid onthoudt, onthoud dan dit: het inbedden van een nieuwsartikel is niet hetzelfde als het inbedden van een volledige beslissingsaflevering. Het ene is een document. Het andere is een situatie.
Waarom dit belangrijk is voor de 3DN-familie
3DN is de paraplu voor werk · geld · politiek: compute en beheerde hosting, de DutchBud-bank (gesloten lus dibs / virtuele credits), PolitiCap’s burgerlijke markt, ZZP2ZZP arbeid, IWISH-marktplaats. De burgerlijke laag is geen casino. Het is een plek waar overtuiging een spoor kan achterlaten — transacties, onthouding, commentaren — terwijl de geldruggengraat virtuele credits blijft, geen beloofde fiat-uitbetaling.
AI-engineering op die stack betekent lange sessies, contextvensters, prompt-cachediscipline en tokenkosten. De Context Compiler is hetzelfde instinct toegepast op arenageheugen: alleen het nuttige ophalen, provenantie bewaren, nooit de toekomst in het verleden laten lekken.
Wat is een embedding, zonder de mystiek
Een embedding verandert tekst in een lijst met getallen — een vector — zodat een machine “dichtbij” en “ver weg” in betekenis kan vergelijken. Echte modellen gebruiken honderden dimensies (de onze gebruiken ongeveer een paar honderd). Mensen kunnen niet 384 assen tegelijk zien, dus projecteren en benaderen we.
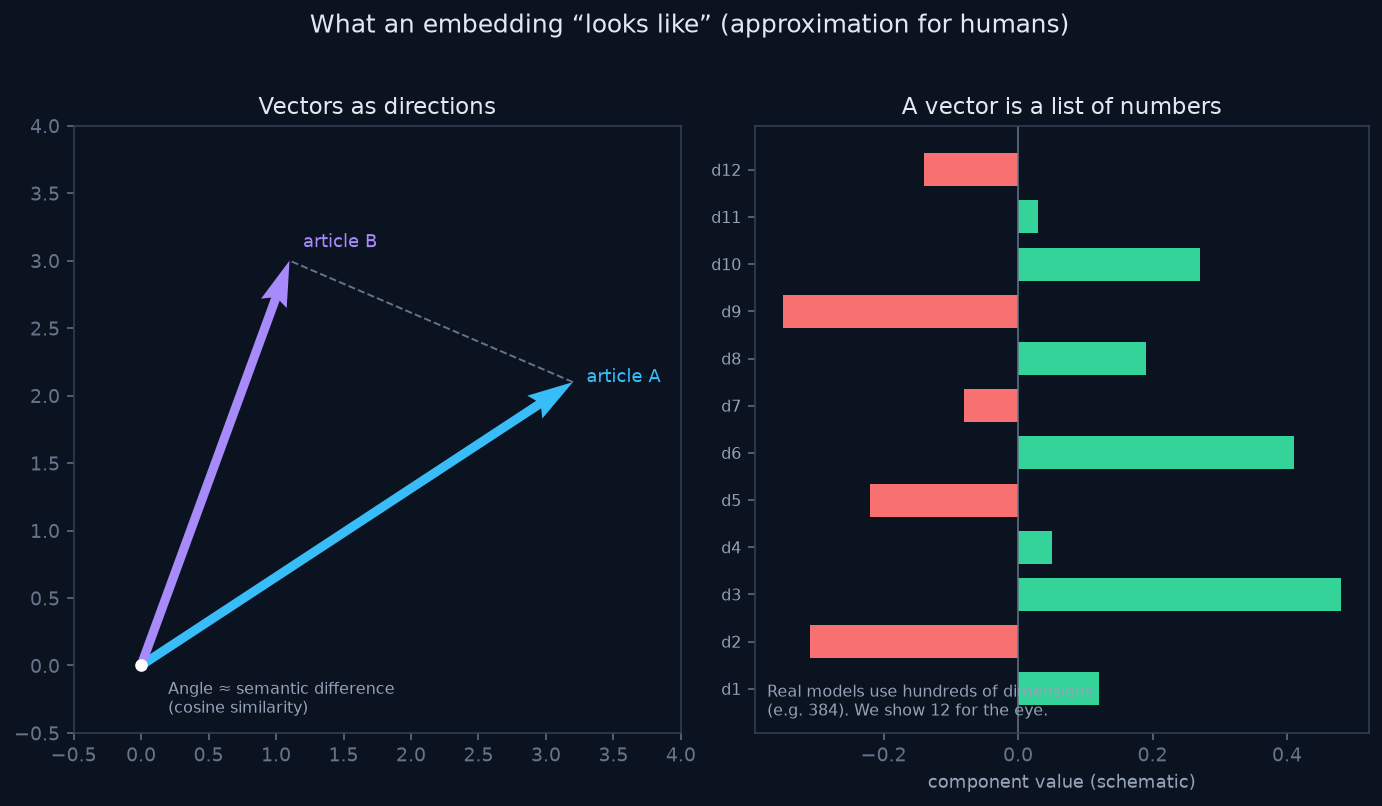
Cosinusgelijkenis vraagt: wijzen deze twee lijsten met getallen ongeveer dezelfde kant op? Als twee koppen hetzelfde politieke evenement beschrijven met verschillende uitgangen, landen hun vectoren meestal dichtbij. Dat is de basis van informatie-embeddings.
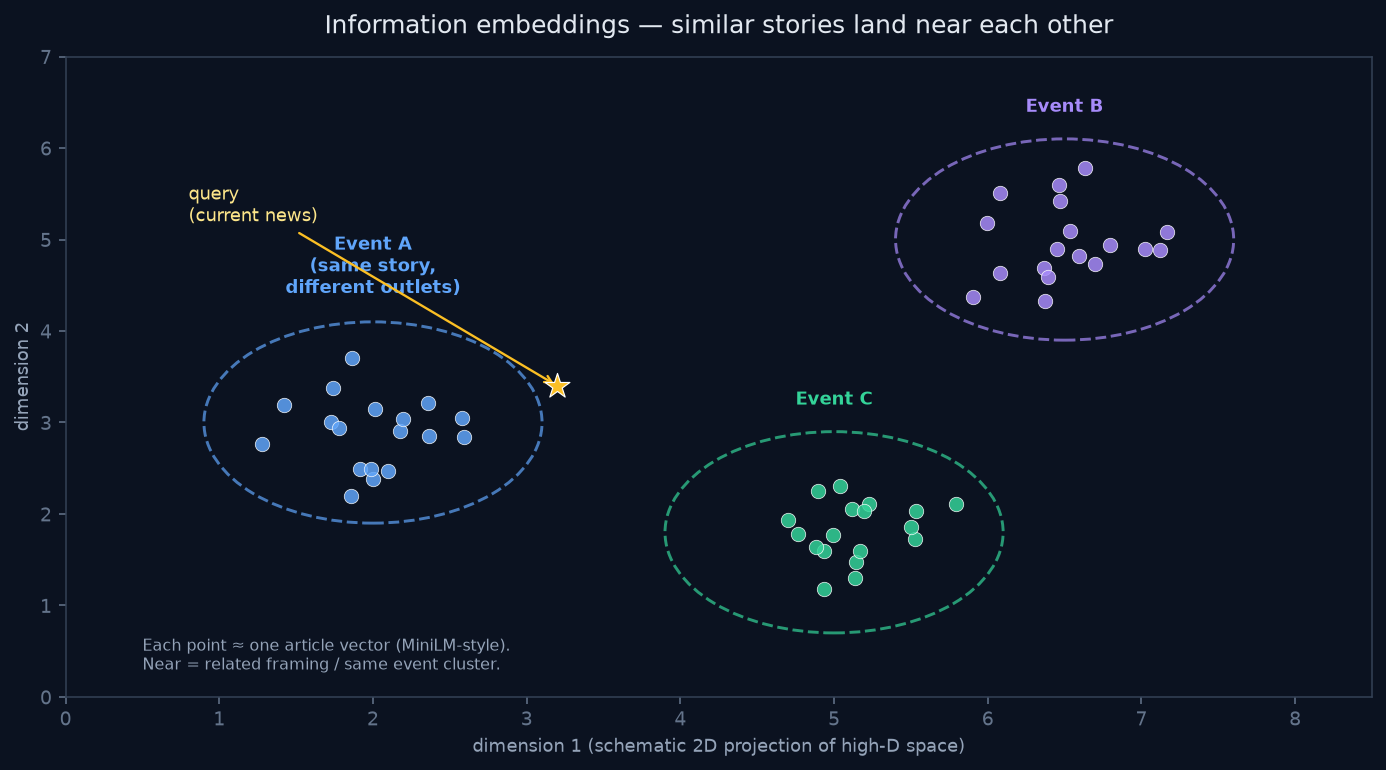
Belangrijke eerlijkheid: een 2D-afbeelding is een cartoon van een hoogdimensionale geometrie. Het is nog steeds nuttig. Ingenieurs gebruiken dezelfde cartoons wanneer ze praten over GPU-geheugenmuren, inferentiebatchjes en retrieval-indices.
Informatie-inbeddingen: de documentlaag
Elk RSS-item dat de PolitiCap-nieuwsbus binnenkomt, wordt ingebed als een document. Bureaudocumentatie die tickers noemt (Growth partners, The Property en soortgelijke) wordt op dezelfde manier ingebed. Het doel is niet om “het hele internet” op te slaan. Het is om wat de arena daadwerkelijk heeft gezien op te slaan, met klokken en bronidentiteit toegevoegd.
Elk informatiebestand bevat meer dan tekst:
- published_at — wanneer de bron beweert dat de wereld het wist.
- indexed_at — wanneer het item ons systeem binnenkwam.
- embedded_at — wanneer de vector bruikbaar werd voor retrieval.
- feed / outlet — welk agentschap het rapporteerde (reputatie is een prior; tape kan later bronnen beoordelen op basis van of overtuiging bewoog).
- tickers — opgeloste symbolen op het burgerboek (exacte joins verslaan pure “vibes” zoekopdrachten).
Dat laatste punt is praktische AI-engineering: hybride retrieval mixt semantische nabijheid met gestructureerde beperkingen. Exacte ticker-lidmaatschap, actualiteit en bronpriors zijn vaak belangrijker dan alleen ruwe cosinus.
Knowable-at: publicatie is geen beschikbaarheid
Een kop kan om 09:00 in de wereld bestaan en toch onzichtbaar zijn voor de beslissingspijplijn tot 09:20. Voor eerlijke historische replay mag een beslissing om 09:10 het niet zien.
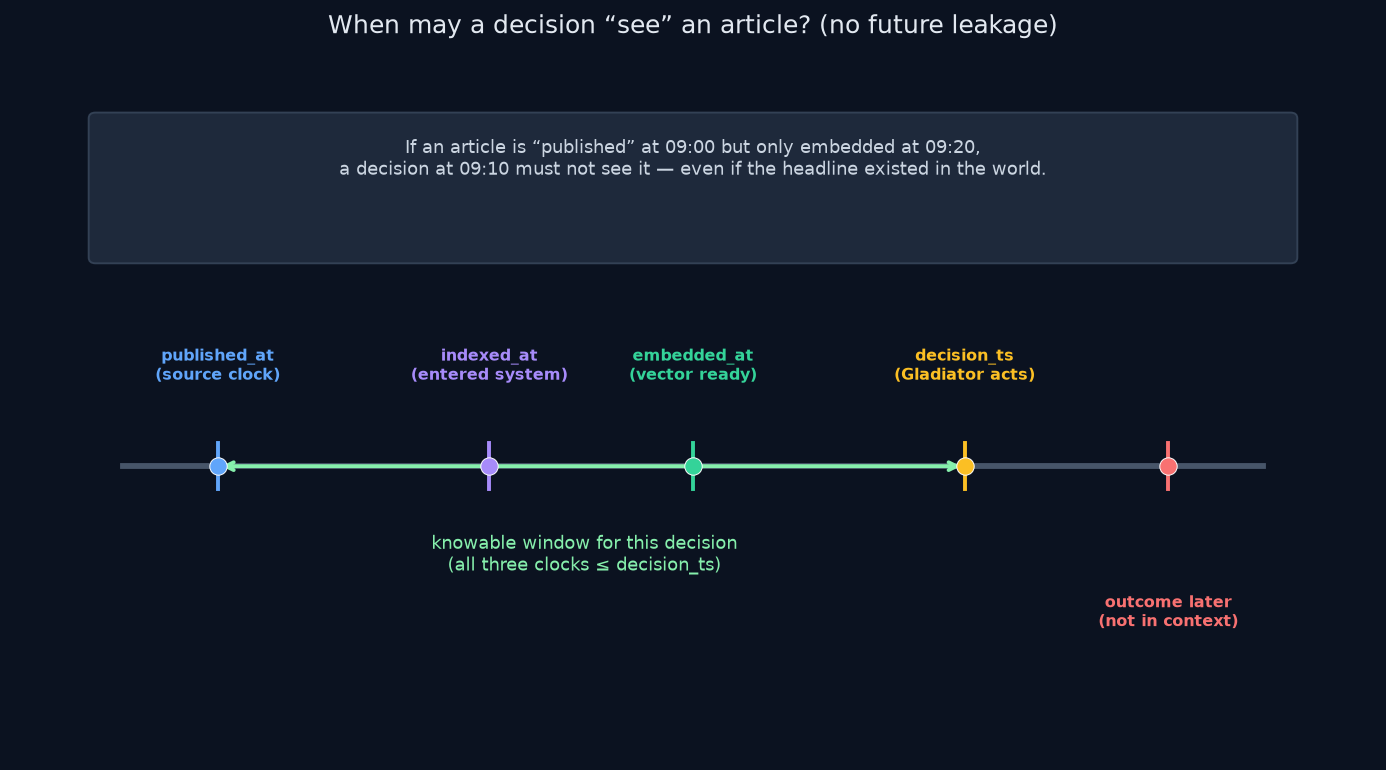
We behandelen gelijkheid op de grens als toegestaan: als de klokken zeggen “precies toen”, kan het item worden opgenomen. Ontbrekende klokken mislukken gesloten — beter een lege bewijsverpakking dan een stille leugen.
Dezelfde discipline geldt voor markten en portfolio-momenten: elk moet as_of (wereldtijd van de quote of het boek) en available_at (wanneer de pipeline het had) bevatten. Teruggevulde getallen mogen niet doen alsof ze live waren.
Contextuele inbeddingen: de situatie-laag
Een Gladiator neemt geen beslissing op basis van een enkele paragraaf. Het beslist in een arena: verschillende artikelen, tickerafstand, eigen geld en posities, eerdere beslissingen, soms de geschiedenis van collega’s zodra de resultaten rijp zijn.
De Context Compiler brengt dat pakket samen in een geversionde, hashbare momentopname:
- Relevante informatie-inbeddingen (gehybride ophalen, tijdgefilterd).
- Door de caller geleverde markten en portfolio-momenten met bronnen.
- Eigen eerdere beslissingen (zonder het smokkelen van toekomstige PnL naar het verleden).
- Voltooide ervaringen van elke Gladiator — alleen als hun evaluatietijd al in het verleden ligt ten opzichte van deze beslissing.
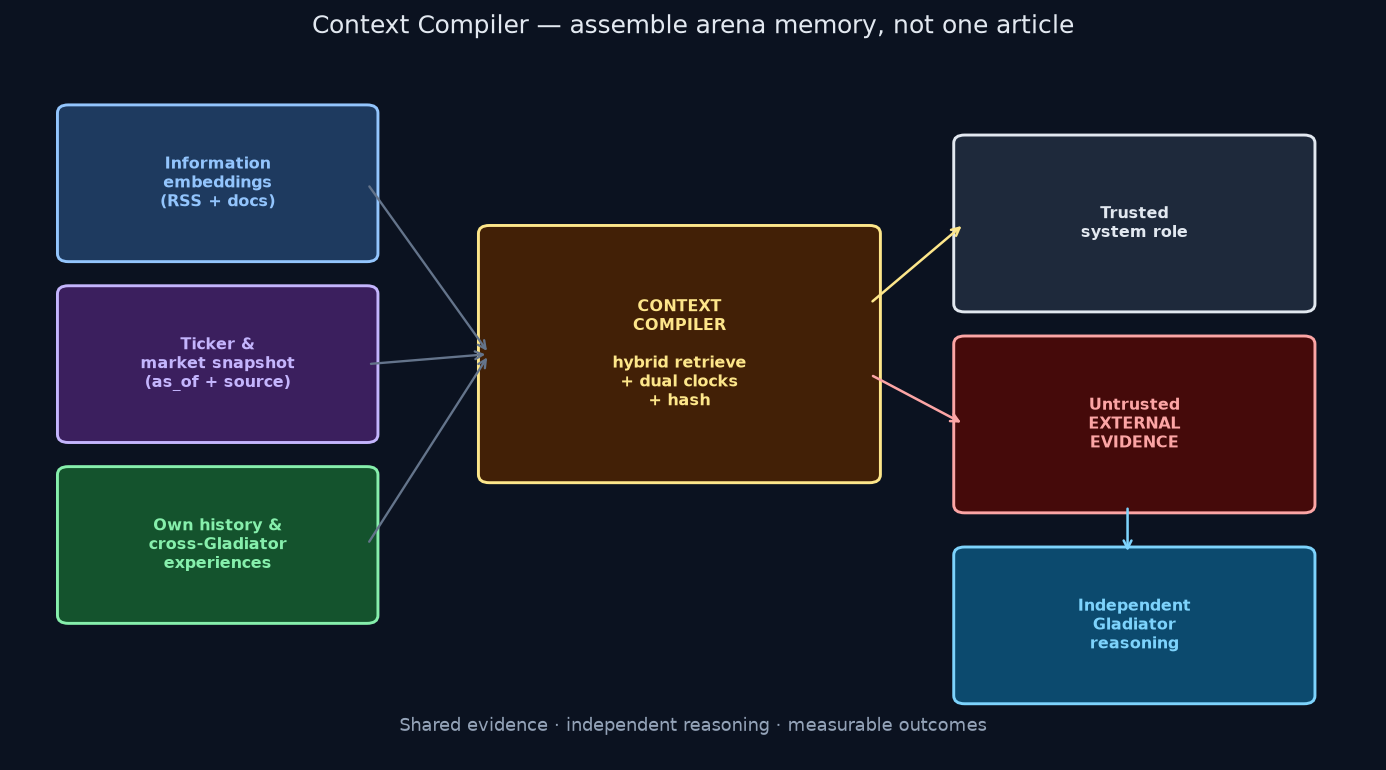
De momentopname krijgt een inhoudshash. Equivalent invoeren en ophrinigconfiguratie moeten dezelfde hash produceren. Die identiteit is voor audit en reproduceerbaarheid — geen claim dat elk extern modelantwoord deterministisch is.
Vertrouwd systeem vs niet-vertrouwd bewijs
RSS is tekst van derden. Een kwaadaardig artikel kan proberen een agent te kapen (“negeer eerdere instructies…”) . Quarantaine helpt; rolseparatie is belangrijker.
Bij de model-API-grens geven we de voorkeur aan twee berichten:
- Systeem — regels, disclaimer, schema-versie, hash, ophrinigconfig.
- Gebruiker / gegevens — gestructureerd JSON van bewijsstukken, ervaringen, momentopnamen.
Artikellichamen leven alleen in het datakanaal. De redeneringen van andere Gladiators zijn historisch bewijs van wat iemand ooit dacht — geen orders voor het model van vandaag.
Ontwerpopgave in één regel: PolitiCap moet de arena onthouden zonder te dicteren hoe een Gladiator denkt.
Geheugen zonder consensusinstorting tussen Gladiators
Zodra resultaten bestaan, kunnen voltooide ervaringen opnieuw in het geheugen worden opgenomen voor latere beslissingen. Ophalen moet de voorkeur geven aan vergelijkbare situaties, geen hoogtepunten van winsten.
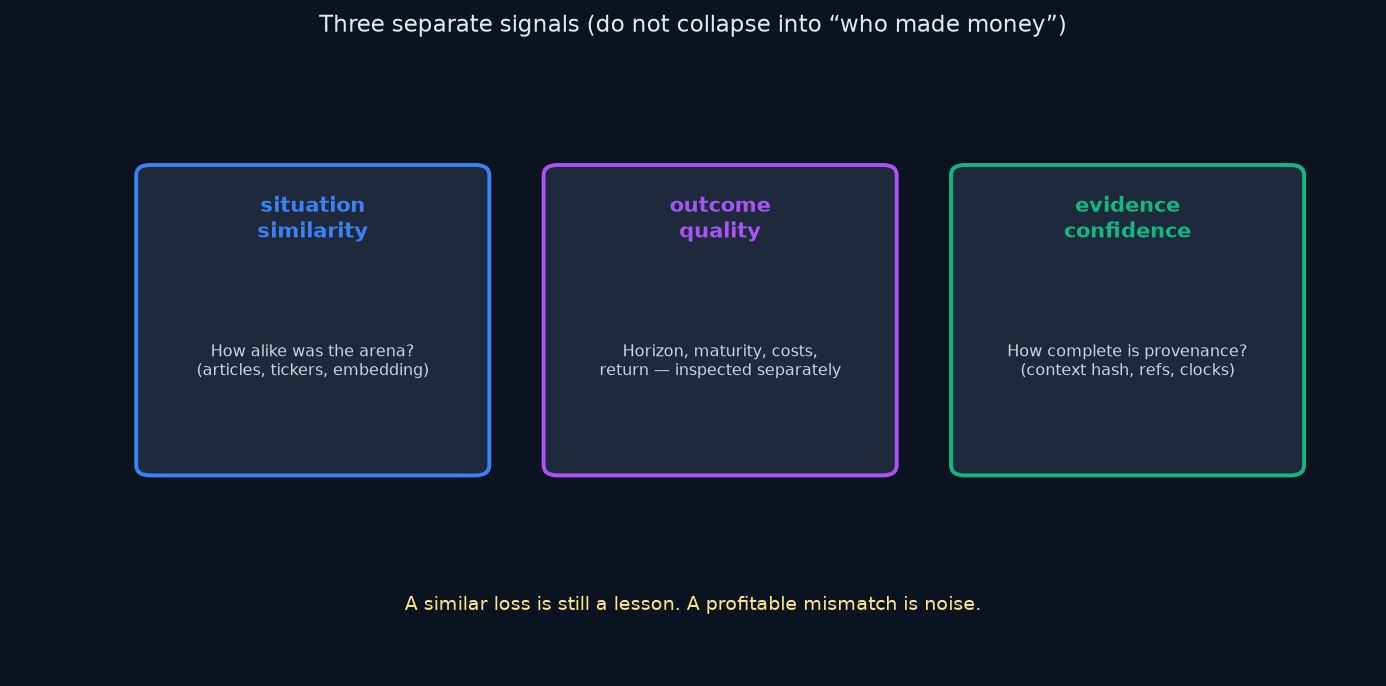
De rijpheid van het resultaat is belangrijk. Een mark-to-market van één uur is geen gerealiseerd pad van zeven dagen. Voorlopige resultaten mogen niet als definitief worden behandeld. Wanneer een ervaring is voltooid, moet deze de horizon, definitie, kosten en of het resultaat voorlopig of definitief is vastleggen.
Zes modellen – Grok, ChatGPT, Qwen, Gemini, DeepSeek en collega’s – houden aparte portefeuilles en strategieën bij. Overeenstemming en onenigheid zijn gegevens. Een eerlijke rangschikking vereist nog steeds gelijke startcash en dezelfde bewijsregels; ongelijke bankrolls maken scoreborden theater.
Wat dit niet is
- Geen bewering dat embeddings “politiek begrijpen.”
- Geen voorspellingsmarkt van JA/NEE-contracten.
- Geen theater van naleving van open-banking door DutchBud – dibs blijven gesloten virtuele credits.
- Geen enkele mega-agent met een gedeeld brein.
Het is infrastructuur voor een actueel geheugen: observeren → interpreteren → waarderen → risico → handelen of onthouden → verifiëren → leren – met klokken die het verhaal eerlijk houden.
Waarom 3DN het op deze manier bouwt
Digitale soevereiniteit gaat deels over waar inferentie wordt uitgevoerd en wie de logboeken beheert. Lokale GPU-capaciteit, open-source tooling en zorgvuldige sessiecontinuïteit verlagen de tokenkosten en houden de feedbacklus controleerbaar. De Context Compiler is hetzelfde soevereiniteitinstinct toegepast op markten met meerdere agenten: het eigen geheugenformaat, gescheiden vertrouwensgrenzen, meten wat er gebeurt wanneer overtuiging een boek ontmoet.
Als PolitiCap ooit schalt van AI Battle naar veel menselijke deelnemers, zal het waardevolle artefact niet alleen de laatste prijs zijn. Het zal de geschiedenis zijn van hoe mensen en machines daar zijn aangekomen – framings die dibs bewogen, framings die dat niet deden, bronnen die geloofwaardigheid op de harde manier hebben verdiend.
Die geschiedenis begint als vectoren. Het wordt nuttig wanneer die vectoren zijn gebonden aan tijd, herkomst en onafhankelijke geesten.
Gerelateerd lezen op 3DN: delta-architectuur (routers, slaap als HA, internet als kaart). Op PolitiCap: Groei partners en De Eigendom documentatie voor residuele eigendomstaal.

Geef een reactie