Frontier-modellen falen in drie operationele tests tegelijk: ze nemen geen nieuwe vaardigheden zonder de oude te riskeren, ze hebben geen nachtdienst, en de serve gewichten zijn de enige kopie. Incidenteel leren, plasticiteit en onderhoud zijn één probleem met drie namen. Het gebruikelijke antwoord is een grotere rivier — meer HBM, meer tokens, hetzelfde mesh.
3DN wil een delta.
Taal is de bus — tokens zijn de valuta
De taak van een LLM is niet alleen om te “spreken”. Na de pretraining heeft het al een gedeelde tokenruimte, controle over het volgende token en een stapel wereldpatronen die via tekst zijn geleerd. Taal is het trainingsmedium en het I/O-formaat. Intern ziet het netwerk nooit Engelse letters; het ziet token-ID’s → embeddings → aandacht → voorspelling van het volgende ID.
Daarom vertrekken modulaire systemen nog steeds vanuit een getraind ruggenmerg: je erft tokenizer, embeddingruimte en gewichten die menselijke tekst al in een bruikbare vectortaal hebben omgezet. Je hangt modules aan die bus. Je vindt geen Engels uit een stapel kleine specialisten en hoopt dat ze later grammatica uitvinden.
Maar een router is een andere taak. Een dispatcher wiens enige uitvoer “welke expert krijgt dit” is, zou niet moeten chatten. Natuurlijke taal is het verkeerde besturingsplan voor die sprong.
Bladeren, geen soep
Een specialist kan ~19k parameters en twintig seconden op een enkele GPU zijn als de taak vast en dicht is — bijvoorbeeld een 8×8 glyf-classifier. Dat netwerk zou nooit eerst Engels moeten zien. Zestig-vier drijvende punten door een chatmodel sturen zodat het kan zeggen “dat lijkt op een A” is langzamer, vager en slechter.
Train de goedkope modellen vanaf nul. Hergebruik de dure. Houd specialist I/O in tensors, klasse-ID’s of een klein codeboek. Gebruik een taalmodel alleen waar de uitvoer taal moet zijn.
| Taak | Juiste modulegrootte |
|---|---|
| 8×8 glyf | 10k–100k |
| Welke expert? (router) | 10k–enkele miljoenen op een embedding |
| Vergelijkbare documenten ophalen | embeddingmodel, geen chatmodel |
| Een uitleg schrijven | LLM |
| De code uitvoeren | interpreter, geen netwerk |
MoE binnen een model ≠ modulaire systemen
In de huidige LLM-gesprekken betekent mix van experts meestal schaarse specialistische FFN’s binnen één Transformer: dezelfde vorm, token-level gate, gedeelde residuele stroom (Mixtral / Switch / DeepSeek-stijl). De industrie-slang is verschoven van oudere “gate + heterogene experts”.
Wat we bedoelen met infrastructuur en AI-engineering bureaus is dichter bij macro-experts: aparte netwerken of modellen, routing op verzoekniveau, specialisten die je offline kunt trainen zonder de schrijver aan te raken. Je kunt beide uitvoeren: de buitenste router kiest het subsysteem; de binnenste MoE kiest welke FFN’s per token afvuren.
De router is de eenheid die je nog kunt leren
Een kleine poort is goedkoop om te herbouwen, niet alleen goedkoop om te gebruiken. Speel een dispatch-log af, breid het uitvoerhoofd uit met een nieuwe klasse, hertrain in minuten – zonder specialisten aan te raken. Vries experts in; alleen de router (en misschien een nieuwe expert) krijgt gradiënten. Nieuw probleemtype = nieuwe expertindex. Oude indices blijven stabiel. Onzeker → fallback generalist, label dan de misser in slaap.
Herhaal de poort waar een grens betaalt: taakfamilie → vaardigheid → versie → fysica. Hetzelfde object stapelen:
verzoek
  → SRAM router     # afmaken in cache / dit die
  → HBM router      # lokale GPU werkset
  → board router    # andere GPU op het knooppunt
  → fabric router   # ander knooppunt
  → region router   # andere faciliteit / verblijf / kosten
Semantiek zegt wat moet draaien. Tier zegt waar het is toegestaan om te draaien. Dat is NUMA-bewuste planning met een trainingssignaal: verkeerde pad + latency + bytes verplaatst + energie + verblijf. De meeste tokens hebben de flood-stage generalist nooit nodig.
Als elke kleine op een geleerde router is, betaal je hop-fout en latency. Gebruik een router wanneer het volgende stuk apart trainbaar is, de moeite waard om te isoleren tegen vergeten, en overgeslagen kan worden voor de meeste invoeren. Route geen goedkope altijd-aan transformatie.
Slaap is HA, geen poëzie
Dichte grens dienende gewichten zijn de kennis. Er is geen reserve lob die je offline kunt halen. Modulaire routing maakt een onderhoudsvenster mogelijk:
- Hot tweeling serveert.
- Cold tweeling herbeleefd, destilleert, snoeit, evalueert.
- Atomaire ruil: cold wordt hot.
- De rest van de DAG blijft draaien.
Dat is hoge beschikbaarheid plus consolidatie – de engineering neef van een droomcyclus. Zet tweelingen op kleine high-churn modules (routers, classifiers, tools). Houd één kopie van de enorme schrijver totdat je het kunt destilleren. Een 20-seconden hertraining op een 3090-klasse box is een realistische slaapcyclus; een volledige grens hertraining is dat niet.
Dit creëert geen biologische plasticiteit binnen een bevroren API-blad. Het omzeilt de mislukking van “één netwerk, één levenslange gradiënt.” Plasticiteit ≈ we kunnen nog steeds capaciteit toevoegen. Incrementerend leren ≈ we kunnen een vaardigheid toevoegen zonder een volledige hertraining. Slaap ≈ we kunnen een module offline herschrijven.
Geheugenmuur: rivier vs delta
Grote LLM inferentie is vaak geheugen-bandbreedte gebonden: trek een enorme gewichtsplaat van HBM, doe een goedkope matmul, trek de volgende plaat. Een netwerk van kleine netten wint wanneer hete experts naast de ALU worden geplaatst en alleen de gewichten van het pad bewegen. De muur beweegt als hops chagrijnig worden over het weefsel – dan ruil je de gewichtsmuur in voor de netwerkmuur.
Gelaagde routers maken afstand zichtbaar. Verkeer dat vermijdt om een 70B plaat te streamen is een feature, geen bug – een gecontroleerde klim op de hiërarchie. Een rivier wordt een vertakte delta: het meeste water verlaat nooit de nabijgelegen kanalen; alleen problemen op overstromingsniveau nemen het diepe kanaal naar de generalist.
Delta’s slibben dicht (dode experts, poorten die altijd promoveren, laaddaling op de standaardroute). Slapen en herhalen is baggeren. Hiërarchie en vastzetten zijn dijken. Terugvallen op het hoofdkanaal is de overstromingsvlakte die je opzettelijk houdt.
De internetrijm
Pakketnetwerken hebben al “enorme types, afstand is duur, onderdelen gaan naar beneden, beleid aan de rand” opgelost. Hiërarchische routers, lokale standaard, promoveren wanneer je moet, intelligentie aan de bladeren – dat is BGP en CDNs met verschillende zelfstandige naamwoorden. Je SRAM/HBM/board/regio-poorten routeren op een ticket (type, budget, verblijfplaats). Specialisten zijn servers.
Gewone doorsturing blijft de standaard. De meeste pakketten moeten betekenen: verplaats deze bits, interpreteer ze niet. Transformatie is een opt-in op aangegeven waypoints (opaque | reduce | policy | enrich) met ontvangstbewijzen. Als de molen slaapt of niet vertrouwd is, draagt het kanaal nog steeds bytes. Een internet dat alleen kan transformeren is een middlebox. Een internet dat kan doorsturen en soms transformeren is een delta met een bypass rond elke molen.
Wat dit niet oplost
- Samenstelling heeft nog steeds een orkestmeester nodig; hybriden zijn pijplijnen, geen één mega-enum van types.
- Gedeelde feiten hebben nog steeds ophaalservice / geheugen nodig, anders splitsen ze zich over de bladeren.
- De open inventaris van probleemtypes wordt ontdekt (clusterresten in slaap), niet volledig ontworpen op dag één. Hiërarchie houdt elke poort klein.
- De slush – taken die niet in een type passen – is waar je nog steeds een grensgeneralist (of een mens) voor betaalt. De taak van de architectuur is om die slush in de loop van de tijd kleiner te maken.
Hoe 3DN de onvolledige versie al uitvoert
Dit is niet alleen een tekening. Op de bureaus van de 3DN-familie routeren we al werk als een hybride stof: grens Grok voor oordeel en lange sessies, lokale GPU-medewerkers voor bulk inference en vertaling, offline getrainde adapters zodat de serverbasis bevroren blijft, verzegelde paden die niet elke hop opnieuw moeten schrijven. DutchBud bank virtuele tegoeden en de PolitiCap burgermarkt zijn familieproducten op dezelfde ruggengraat — werk · geld · politiek — met dibs als speeltegoeden in een gesloten lus, geen casino-uitbetaling en geen gelicentieerde open-banking-claim.
PolitiCap’s openbare tape is een vroege macro-router in het wild: benoemde bestemmingen (tickers), alleen toevoegen van ontvangstbewijzen (commentaren en vullingen), optionele tweede hops wanneer de eerste doorlaat conflicten. WordPress is een vreselijke tensorstof en een behoorlijke off-board bus voor politiek kapitaal. Dezelfde regel is van toepassing: standaard doorsturen; debat is een optionele tussenstop met een hop-budget — niet vijf volledige salons op elke kop.
Het artikel is de tekening. De bureaus zijn de eerste kreken. Bouw de delta: kleine experts, warme/koude slaap, gelaagde afstand, ondoorzichtig voorwaarts als standaard. Vind geen taal uit modules. Vind modules bovenop taal — en plaats een wegwerfgate voor elk duur pad.
Update: Dream-RSI en de offline droomloop
16 september 2026. Een veelgedeelde post door @thesupermannx (Superman) vertaalde Dream-RSI — Google DeepMind’s open-source werk aan recursieve zelfverbetering — naar eenvoudig taalgebruik. De claim is niet “een grotere stroom van live uitrol”. Het is een delta van ervaring: log wat de agent al heeft ontdekt, verander die geschiedenis in een offline replay simulator, en laat het systeem daar betere verkenningsbeleid dromen voordat het online weer echte compute besteedt.
Superman’s samenvatting, samengeperst:
- De muur. Zelfverbeterende agenten moeten verkennen. Elke nieuwe idee live testen (online evaluatie) is traag, duur en GPU-intensief — zoals schaken leren door alleen volledige toernooien te spelen.
- De zet. Elke echte ontdekking wordt vastgelegd. Dream-RSI bouwt een droomwereld van die opgebouwde geschiedenis. Nieuwe strategieën worden binnen de simulator verfijnd tegen bijna-nul uitrolkosten, en vervolgens online opnieuw ingezet.
- De lus. Droom offline → online inzetten → de geschiedenis uitbreiden → opnieuw dromen, slimmer. DeepMind richt de stapel al op algoritme-engineering, wiskundige optimalisatie en GPU kernelwerk.
- De pointe. Voorbij “antwoord en code” modellen, naar systemen die hun eigen upgrades uitvinden. Geschiedenis wordt de wereld waarin de agent droomt. Projectsite: dream-rsi.com.
Dat sluit aan bij de ruggengraat van dit artikel zonder de metafoor uit te rekken. Slaap is geen optionele decoratie: het is de HA nachtschift waar gewichten en beleid kunnen bewegen zonder het live pad offline te halen. Een partnerroute blijft ploeteren terwijl een andere node droomt — dezelfde reden waarom we modulaire inferentie en hete/koude experts willen in plaats van één monolithisch dienend mesh. Open source Dream-RSI voltooit de architectuur niet (null-space van basiscompetentie, toegestane sandboxes, lokale oversight UI doen er nog steeds toe). Het valideert wel de richting: verbeter in de delta; behandel niet elke live sprong als de enige school.
De gezinsbureaus van 3DN draaien al een ruwe versie van die splitsing — grens Grok voor oordeel, lokale GPU-werkers voor bulktaken, offline getrainde adapters zodat de dienende basis bevroren blijft. Dream-RSI is de onderzoekskwaliteit naam voor hetzelfde instinct: recursieve zelfverbetering heeft een plek nodig om te slapen.
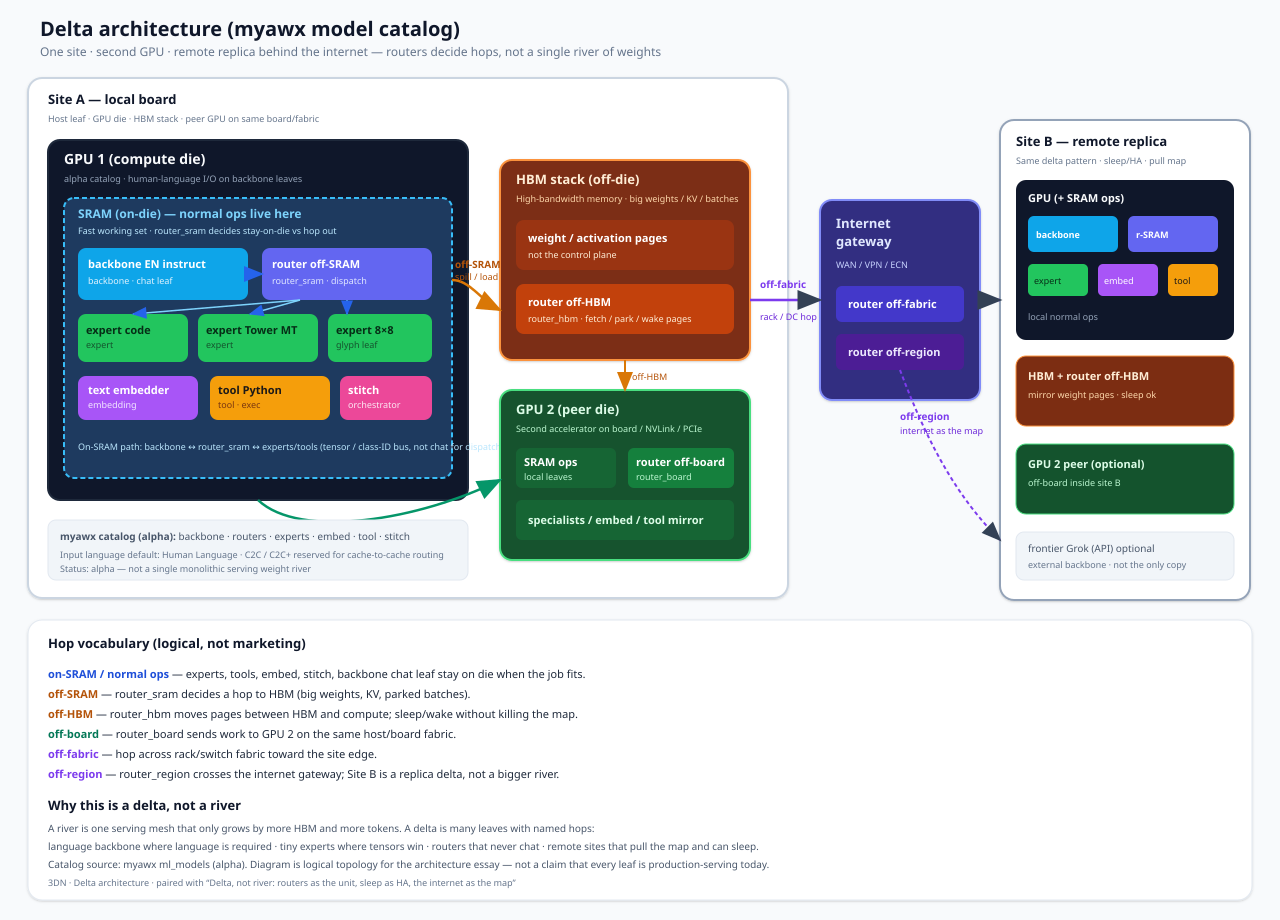
Map of the delta (GPU → HBM → peer GPU → internet)
The essay above argues for a delta instead of a single serving river. The figure makes that concrete using the same leaf types we track in myawx (status alpha): backbone, routers at each hop distance, experts, embedder, tool, and stitch.
1) The GPU itself
The dark block is the compute die — where work is scheduled. It is not “the model.” It is the machine that hosts many leaves. A frontier chat weight can sit here as a backbone leaf, but so can a 19k-parameter glyph net that should never see English first.
2) Models running inside the GPU
Inside the die we place the leaves that belong on-site for normal traffic:
- backbone EN instruct — language bus / chat leaf when the output must be language.
- expert code, expert Tower MT, expert 8×8 glyph — dense specialists (tensors / class IDs, not chat for control).
- text embedder — retrieve / encode.
- tool Python exec — deterministic side effect, not a net.
- stitch / aggregator — orchestrator that composes leaf outputs.
3) SRAM — where normal operations occur
The dashed cyan region is on-die SRAM: the fast working set. This is the default home for “stay local” jobs. The router off-SRAM leaf (router_sram) is the dispatcher whose only job is stay on die versus hop out. A router should not chat; natural language is the wrong control plane for that hop.
4) HBM chip
Beside the die sits the HBM stack — high-bandwidth memory for large weight pages, KV, parked batches. The router off-HBM leaf (router_hbm) moves pages between HBM and compute: spill, load, sleep, wake. That is how maintenance and night shift become possible without treating the live mesh as the only copy of the world.
The logical edge is labeled off-SRAM (die → HBM) and off-HBM (HBM pages ↔ compute / peer paths).
5) A second GPU
GPU 2 is a peer accelerator on the same board or host fabric (NVLink / PCIe class links). The router off-board leaf (router_board) sends work across that hop when Site A’s first die is full, asleep, or the wrong specialist lives next door. Same delta pattern: local SRAM ops, optional specialists — not a second river.
6) Internet gateway and the replica
Right of the local board: an internet gateway carrying router off-fabric (router_fabric, rack/DC edge) and router off-region (router_region, WAN / VPN / ECN-style map). Behind it, Site B repeats the diagram in miniature: GPU + SRAM leaves, HBM + off-HBM, optional peer GPU, and an optional external frontier Grok (API) backbone that is not allowed to be the only copy.
That is the punchline of the essay in one picture: the internet is the map. Remote sites pull topology, sleep for HA, and wake without requiring one eternal serving mesh.
Hop vocabulary (quick reference)
| Hop | myawx type | Meaning |
|---|---|---|
| on-SRAM / normal ops | backbone, expert, embedding, tool, orchestrator | Job fits the die working set |
| off-SRAM | router_sram | Leave die toward HBM or further hops |
| off-HBM | router_hbm | Page move / park / wake on the stack |
| off-board | router_board | Peer GPU on the same host/board |
| off-fabric | router_fabric | Rack / switch / DC fabric toward the edge |
| off-region | router_region | Across the gateway to a remote delta replica |
Catalog status in myawx for these leaves is alpha; default input language is Human Language, with C2C / C2C+ reserved for cache-to-cache routing later. The diagram is a logical topology for this architecture — not a claim that every leaf is production-serving today.

Geef een reactie