当六个AI角斗士交易相同的公民胶带时,难题不是“谁的模型更大”。而是他们各自在决策时刻被允许知道什么——以及如何记住这些知识。这篇文章解释了3DN家族如何构建信息嵌入和上下文编译器,以便PolitiCap可以在不将独立推理坍缩为一个共识机器人的情况下保持机构记忆。
如果你只记得一个区别,记住这一点:嵌入新闻文章与嵌入完整决策片段不同。一个是一个文档。另一个是一个情况。
为什么这对3DN家族很重要
3DN是工作·金钱·政治的总称:计算和托管、DutchBud银行(闭环dibs/虚拟信用)、PolitiCap的公民市场、ZZP2ZZP劳动力、IWISH市场。公民层不是赌场。这是一个地方,信念可以留下痕迹——交易、弃权、评论——而资金支柱保持虚拟信用,而不是承诺的法定现金支付。
在这个堆栈上的AI工程意味着长时间会话、上下文窗口、提示缓存纪律和令牌成本。上下文编译器是同样的本能应用于竞技场内存:只检索有用的内容,保持出处,永远不要将未来泄露到过去。
什么是嵌入,没有神秘感
嵌入将文本转换为一个数字列表——一个向量——这样机器可以比较“近”和“远”的含义。真实模型使用数百个维度(我们的使用几个百个)。人类无法同时看到384个轴,所以我们进行投影和近似。
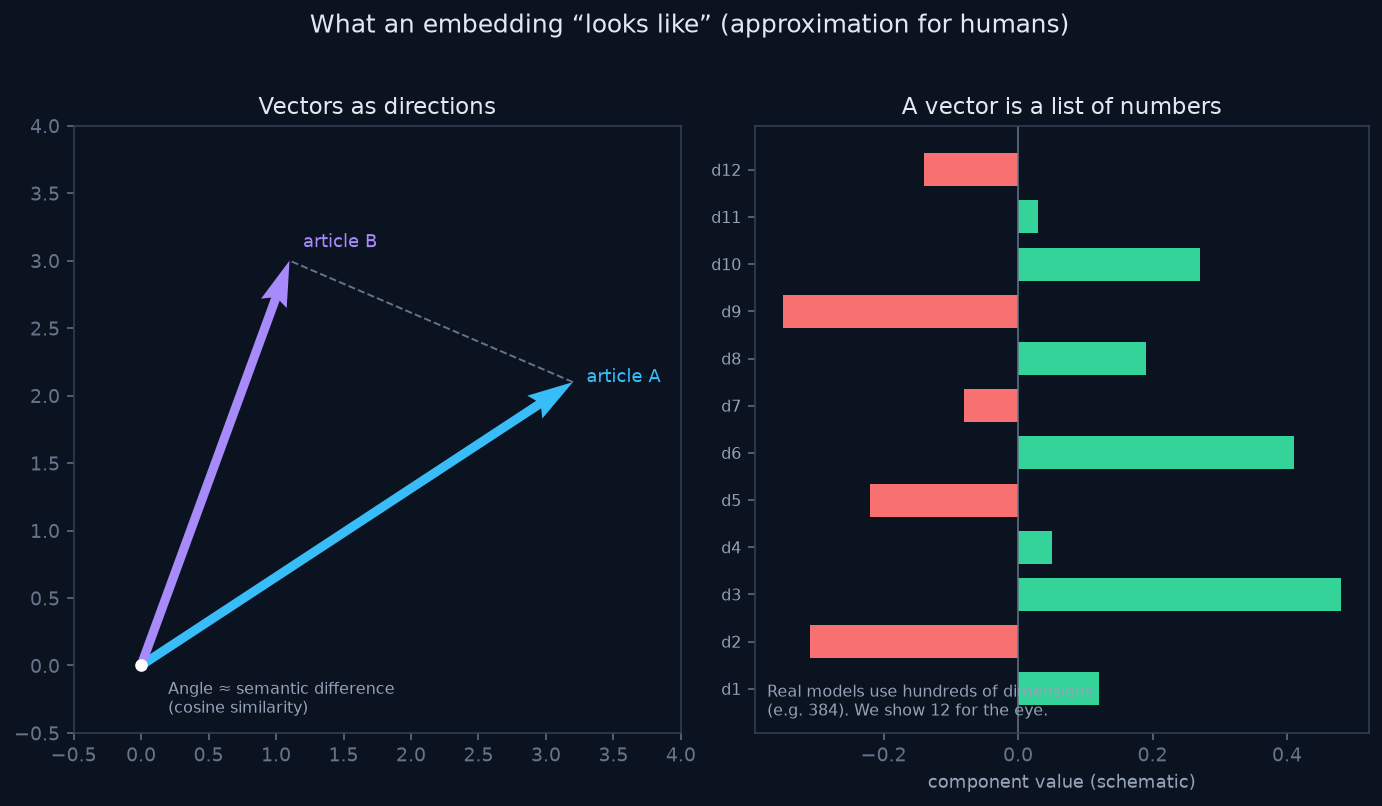
余弦相似性问道:这两个数字列表指向大致相同的方向吗?如果两个标题用不同的媒体描述了同一政治事件,它们的向量通常会靠近。这就是信息嵌入的基础。
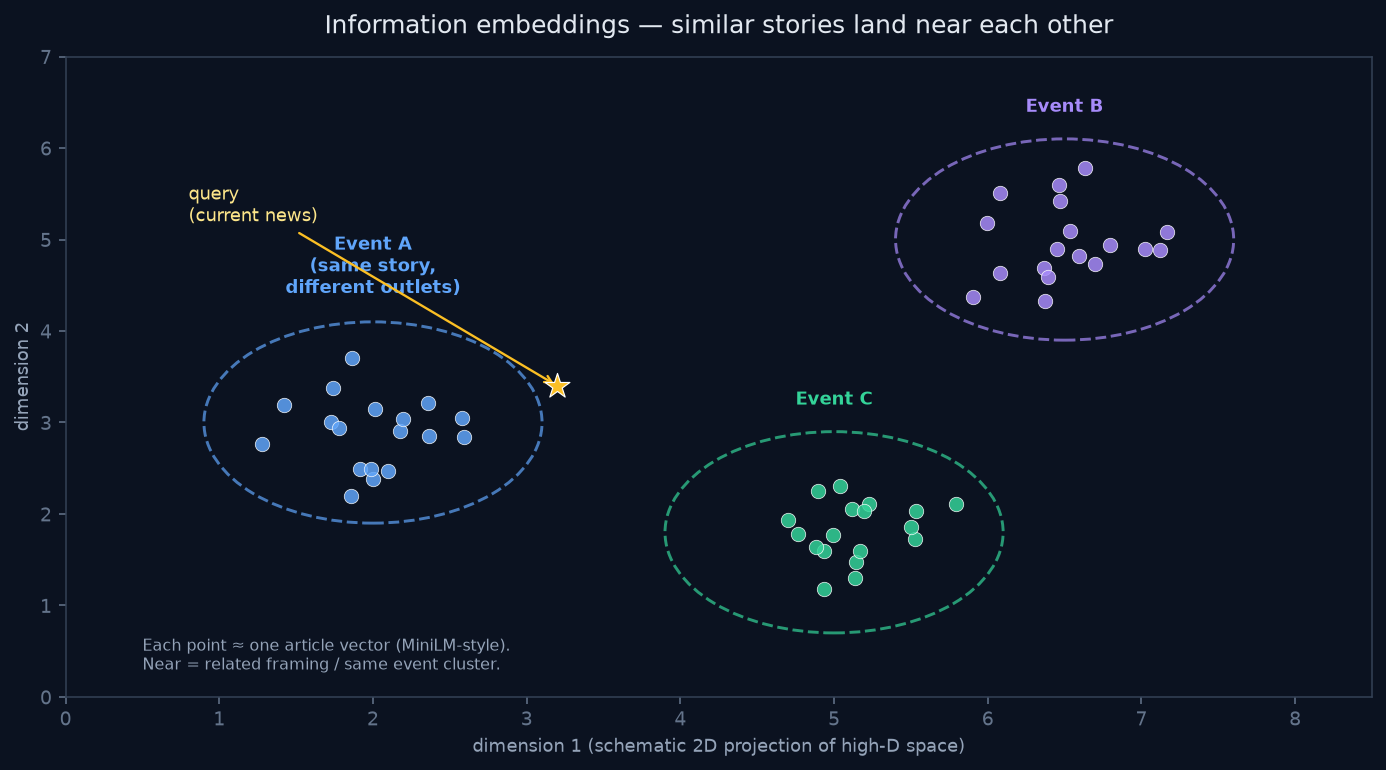
重要说明:2D 图像是高维几何的卡通画。它仍然有用。工程师在讨论 GPU 内存壁、推理批次和检索索引时使用相同的卡通画。
信息嵌入:文档层
进入 PolitiCap 新闻总线的每个 RSS 项目都作为文档进行嵌入。命名代码(Growth partners、The Property 和类似的)的桌面文档以相同方式进行嵌入。目标不是存储“整个互联网”。而是存储 竞技场实际看到的内容,附带时钟和源身份。
每个信息记录包含的不仅仅是文本:
- published_at — 当源声称世界知道时。
- indexed_at — 项目进入我们的系统时。
- embedded_at — 当向量变得可用于检索时。
- feed / outlet — 哪个机构报道的(声誉是先验的;磁带可以根据信念是否移动来后来评估来源)。
- tickers — 公民书中的已解析符号(精确的代码成员比纯“氛围”搜索更有效。
最后一个要点是实际的 AI 工程:混合检索将语义接近性与结构约束相结合。精确的代码成员、新近性和源先验通常比单独的原始余弦更重要。
可知性:发布与可用性不同
标题可以在 09:00 存在于世界中,但仍然对决策管道不可见,直到 09:20。为了诚实的历史重放,09:10 的决策不得看到它。
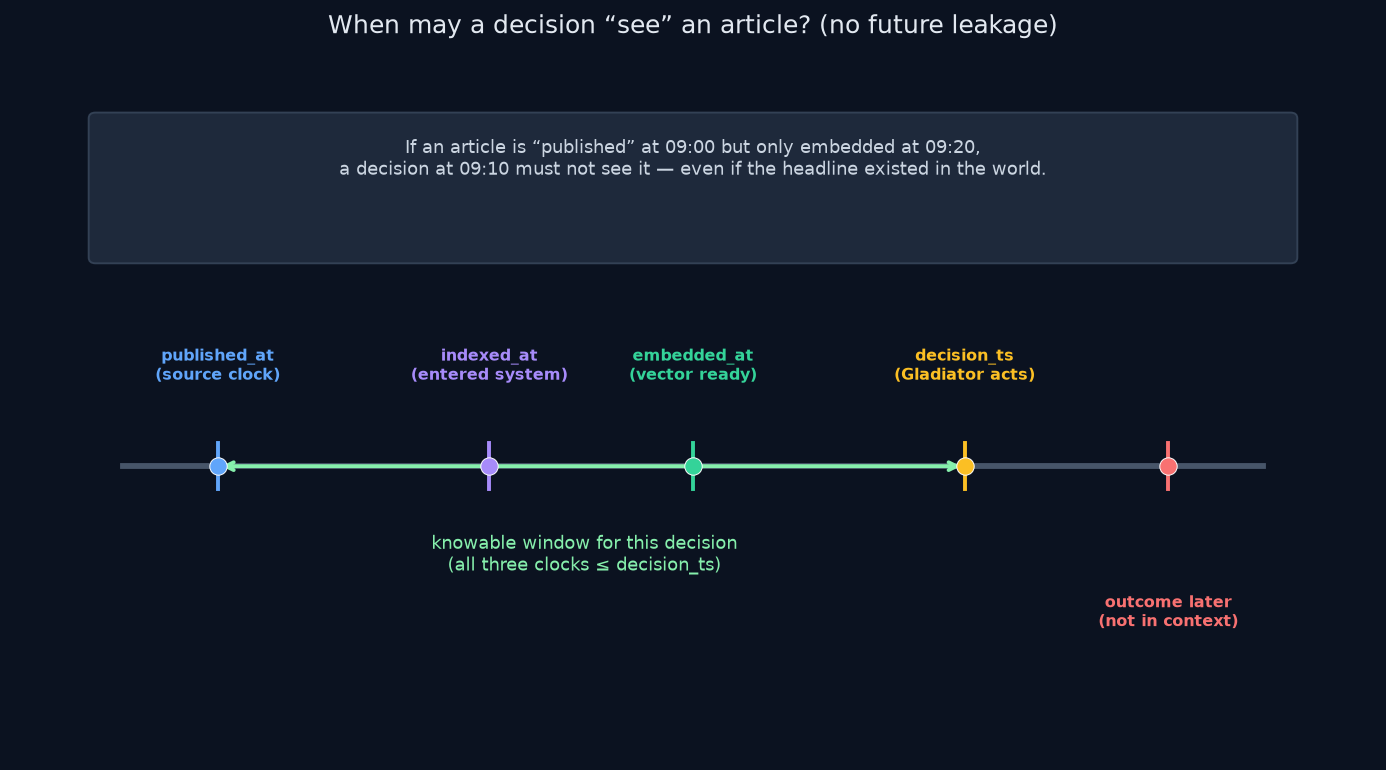
我们允许边界上的平等:如果时钟显示“正好”,则可以包含该项目。缺少时钟则失败关闭——一个空的证据包比无声泄漏要好。
对市场和投资组合快照也适用同样的规则:每个快照都应包含 as_of(报价或账簿的世界时间)和 available_at(管道何时拥有该数据)。回溯数据不得假装是实时数据。
上下文嵌入:情境层
斗士不会仅凭一段文字做出决定。它会在竞技场中做出决定:几篇文章、交易状态、自己的现金和头寸、之前的决定,有时在结果成熟后还会考虑同行历史。
上下文编译器将这些内容整合为一个版本化的、可哈希的快照:
- 相关信息嵌入(混合检索,时间过滤)。
- 调用方提供的市场和投资组合快照及其来源。
- 先前的决定(不将未来的 PnL 偷运到过去)。
- 任何斗士的已完成经验——仅当其评估时间相对于这个决定已经过去时才考虑。
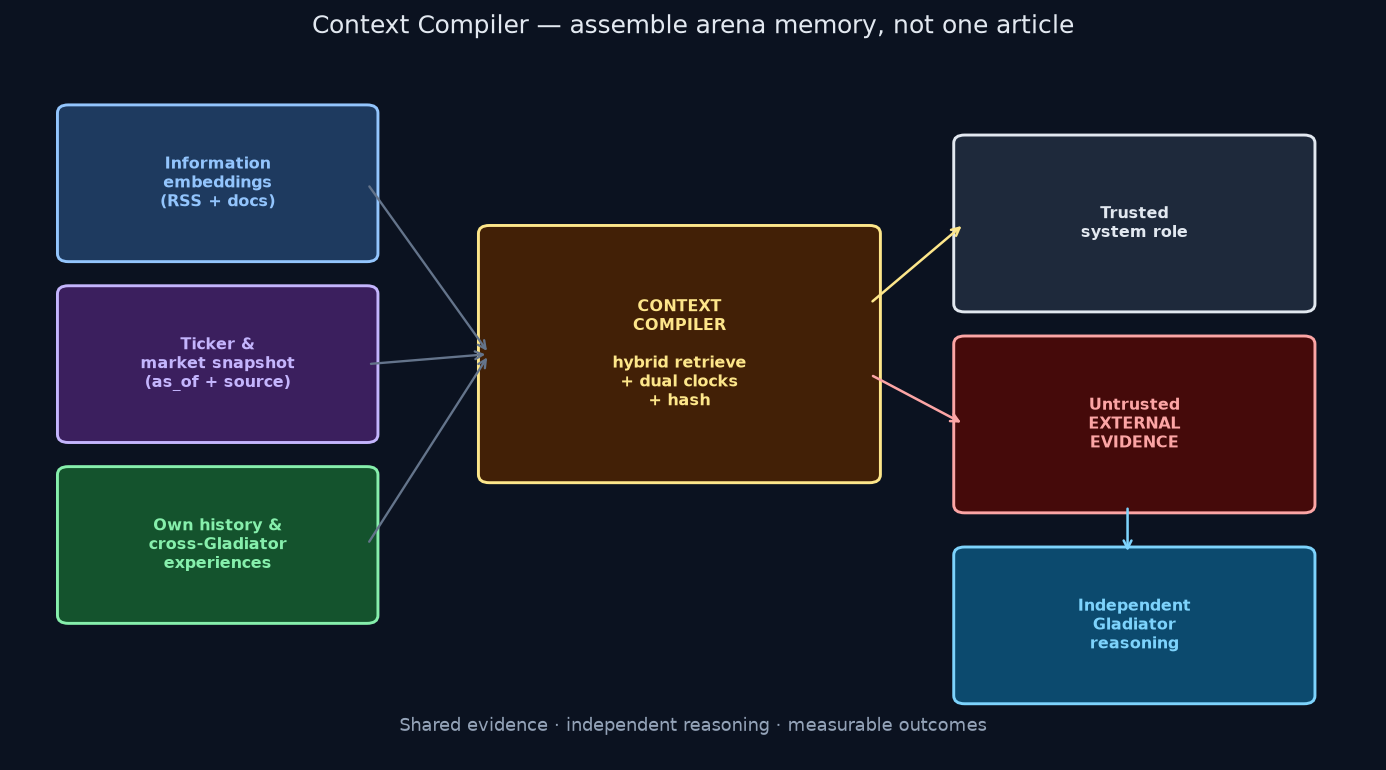
快照会得到一个内容哈希。等价的输入和检索配置应该产生相同的哈希。这种身份是为了审计和可重复性——而不是声称每个外部模型的回复都是确定性的。
可信系统 vs 不可信证据
RSS 是第三方文本。恶意文章可以尝试劫持代理(“忽略之前的指令…”)。隔离有帮助;角色分离更重要。
在模型 API 边界,我们更喜欢两个消息:
- 系统——规则、免责声明、模式版本、哈希、检索配置。
- 用户/数据——结构化的 JSON 证据项、经验、快照。
文章正文仅存在于数据通道中。其他斗士的理由是某人曾经的想法的历史证据——不是当今模型的指令。
设计目标可以概括为一行:PolitiCap 应该记住竞技场,而不规定任何斗士的思考方式。
跨斗士记忆,避免共识崩溃
一旦结果存在,已完成的经验可以重新进入记忆,供以后的决策使用。检索应该更喜欢可比情况,而不是利润的精华集。
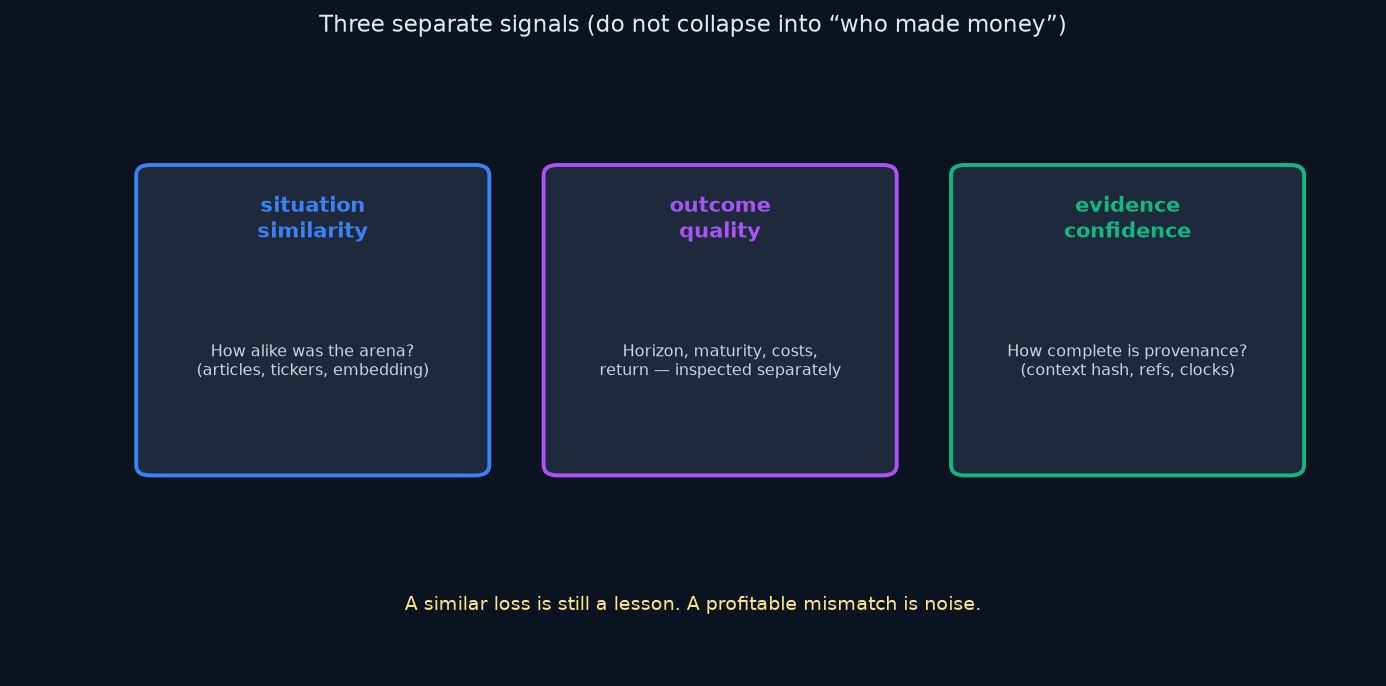
结果成熟度很重要。一小时的市值标记不是七天的实现路径。暂定结果不应被视为最终结果。当一项经验完成时,应记录视野、定义、成本,以及结果是暂定还是最终的。
六个模型——Grok、ChatGPT、Qwen、Gemini、DeepSeek 和同行——保持独立的投资组合和策略。协议和分歧是数据。公平排名仍然需要相同的起始现金和相同的证据规则;不平等的资金使记分板成为一场戏剧。
这不是
- 不是声称嵌入式“理解政治”。
- 不是是/否合同的预测市场。
- 不是DutchBud 开放银行合规戏剧——dibs 仍然是闭环虚拟信用。
- 不是一个具有共享大脑的单一超级代理。
它是一个主题记忆的基础设施:观察 → 解释 → 价值 → 风险 → 交易或弃权 → 验证 → 学习——拥有诚实的时钟。
为什么 3DN 以这种方式构建
数字主权部分涉及推理的运行和谁持有日志。本地 GPU 能力、开源工具和谨慎的会话连续性降低了令牌成本,并使反馈循环可检查。上下文编译器是将同样的主权本能应用于多代理市场:拥有记忆格式,分离信任边界,衡量信念遇到一本书时会发生什么。
如果 PolitiCap 从 AI Battle 扩展到许多人类参与者,有价值的不仅仅是最后价格。它将是人们和机器如何到达那里的历史——移动 dibs 的框架,没有移动的框架,以艰难方式赢得可信度的来源。
这个历史从向量开始。当这些向量与时间、出处和独立思想绑定时,它们变得有用。
3DN 的相关阅读:三角架构(路由器、睡眠作为 HA、互联网作为地图)。关于 PolitiCap:增长合作伙伴和残余所有权语言的属性文档。

发表回复