


BF16 在我们自己的 GPU 上:delta-nn 训练速度快 1.4 倍——Oracle 即将来临
我们在本地 NVIDIA 芯片上用 BF16 重新训练了 delta-nn:比 FP32 快 1.4 倍。引用的 RTX 30 解锁故事引领行业潮流;真正的多 GPU 优势需等待我们的下一款产品。矩阵预告:delta-nn 成为 PolitiCap 角斗士的奥秘武器。
我们在本地 NVIDIA 芯片上用 BF16 重新训练了 delta-nn:比 FP32 快 1.4 倍。引用的 RTX 30 解锁故事引领行业潮流;真正的多 GPU 优势需等待我们的下一款产品。矩阵预告:delta-nn 成为 PolitiCap 角斗士的奥秘武器。
Delta、3DN 多代理计算架构现已成为编码代理的生产基础设施——温暖座位、人工输入、动态图像生成、本地 GPU 优先故障转移,以及仅通过推送提醒即可注意到的网格恢复。
3DN如何将新闻转化为向量,为PolitiCap Gladiators组装决策时间竞技场内存,并在不泄露未来到过去的条件下保持独立的人工智能推理。
前沿模型是一条重量级河流。3DN勾勒出三角洲:小型专家、分层路由器、睡眠双胞胎、默认不透明向前——模块化人工智能工程对抗遗忘和记忆墙。

聊天式大型语言模型没有永久目标。市场有几十年的数据;政治家的价值没有。一个冻结的英语基础、最大化收益的目标,以及可插拔的 LoRA 适配器——在 PolitiCap 和 DutchBud 账本数据渗透的情况下离线训练。
我们正在 Unbabel TowerInstruct-7B 上构建一个小型 LoRA,以便英语到泰语的机器翻译可以在我们自己的 GPU 上进行改进,而无需在每段文本上使用边界标记。
我们向本地 Qwen2.5-Coder 14B 编码代理(运行在我们的 Gaia GPU 上)提交了一个真正的多文件 React Native 功能。它报告成功。Git 保持干净。以下是故障模式——以及我们现在如何分配 AI 工程工作。
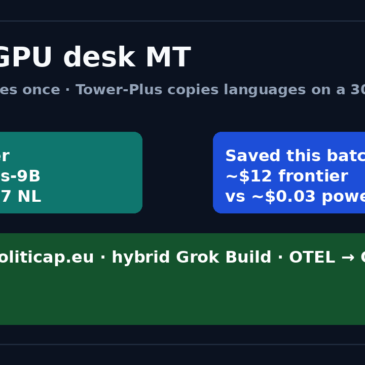
混合Grok桌面:前沿判断,盖亚塔,EN→ZH/NL。本地翻译59篇文章;节省这批约12美元。
在我们的编码桌面上,开放权重输给了 Grok 4.5,四路 3090 + EPYC 盒子看起来像是撤资。混合是 Grok Build 的一流功能:将 Grok 保留在 API 上进行判断,将大量转换卸载到本地推理 – 并进行成本计算。

到 2031 年 8 月 11 日,中国前沿人工智能的主要路径不再依赖于偷运的 NVIDIA 主板和西方 HBM。这场竞赛涉及的是内存壁垒、封装、兆瓦和编译器——而不是下一个小玩意路线图。
